Mac Studio M5 Ultra: l’AI locale diventa una workstation personale
Memoria fino a 512GB e acceleratori neurali portano i grandi modelli AI direttamente sulla scrivania.
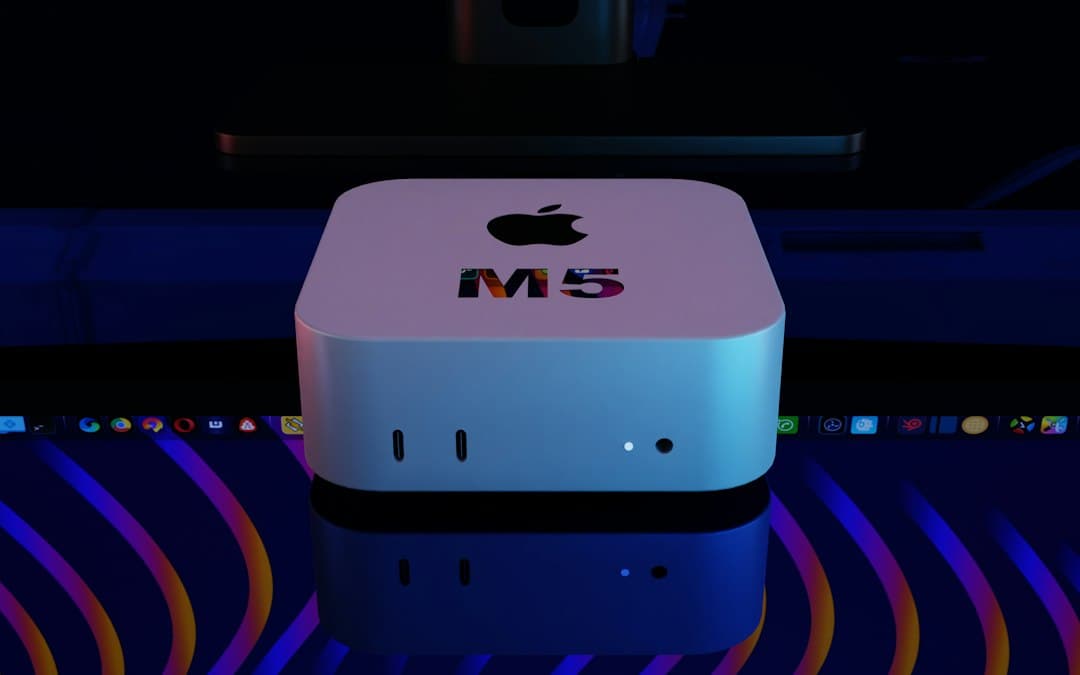
Per anni il Mac Studio è stato soprattutto una workstation compatta destinata a montaggio video, grafica 3D, musica e sviluppo software. Con il chip M5 Ultra, però, Apple gli assegna un ruolo più ambizioso: diventare un computer capace di eseguire grandi modelli di intelligenza artificiale direttamente sulla scrivania, senza dipendere necessariamente dai data center.
La prova pubblicata da WIRED il 1° ottobre 2026 offre un esempio concreto. Su una configurazione con 256GB di memoria unificata, la testata ha eseguito offline un modello Qwen 3.5 da 122 miliardi di parametri, ottenendo un’esperienza descritta come vicina, per velocità e reattività, a quella dei servizi AI più avanzati. Non significa che un modello locale sia automaticamente equivalente ai migliori sistemi proprietari: dimostra, però, che una classe di applicazioni prima riservata ai server può ora entrare in un computer relativamente compatto.
Perché la memoria conta più del semplice numero di core
Il principale vantaggio del Mac Studio non risiede soltanto nella potenza di calcolo. Il fattore decisivo è la memoria unificata, condivisa da CPU e GPU senza la rigida separazione tra RAM di sistema e memoria video tipica di molte workstation tradizionali.
Il modello con M5 Ultra può arrivare a una CPU da 36 core, una GPU da 80 core, 512GB di memoria unificata e una banda dichiarata di 1,2 TB al secondo. Secondo Apple, la banda è superiore del 50% rispetto alla generazione precedente, mentre le prestazioni AI di picco possono raggiungere 4,3 volte quelle del Mac Studio con M3 Ultra. Si tratta di misurazioni interne, quindi da leggere considerando modelli, precisione numerica e software utilizzati nei singoli test.
La quantità di memoria determina quali modelli possono essere caricati. Un modello da 122 miliardi di parametri quantizzato a 4 bit richiede, per i soli pesi, circa 61GB. A questa cifra vanno aggiunti cache, contesto, strutture del runtime e memoria per le altre applicazioni. Ecco perché passare da 64GB a 256 o 512GB non rappresenta un semplice lusso: cambia materialmente la classe di modelli utilizzabili.
| Caratteristica | Mac Studio con M5 Ultra |
|---|---|
| CPU | Fino a 36 core |
| GPU | Fino a 80 core con Neural Accelerator |
| Memoria unificata | Fino a 512GB |
| Banda di memoria | Fino a 1,2 TB/s |
| Connettività | Fino a 6 porte Thunderbolt 5, Wi-Fi 7 e Bluetooth 6 |
| Prezzo di partenza in Italia | 6.699 euro |
Cosa significa davvero eseguire un modello “frontier” in locale
Dimensioni e qualità non sono sinonimi
Poter caricare un modello con centinaia di miliardi di parametri non garantisce automaticamente risultati pari ai migliori servizi cloud. Contano anche dati di addestramento, architettura, capacità di ragionamento, strumenti integrati e ottimizzazione del runtime.
L’espressione frontier-level va interpretata con cautela. Nel caso della prova di WIRED indica soprattutto la possibilità di lavorare con modelli open-weight di grandi dimensioni e con tempi di risposta credibili su un singolo dispositivo. Non dimostra una parità generale con i sistemi proprietari più avanzati, addestrati e distribuiti su infrastrutture enormemente più costose.
I vantaggi dell’elaborazione locale sono comunque rilevanti. Documenti riservati, codice sorgente, archivi aziendali e dati di ricerca possono essere analizzati senza inviare ogni prompt a un fornitore esterno. Inoltre, non esiste una tariffa per token e il sistema può continuare a funzionare offline. Il risparmio reale dipende però dall’intensità d’uso: una workstation da migliaia di euro è difficilmente conveniente per chi interroga un chatbot poche volte al giorno.
La ricerca sull’inferenza in Apple Silicon conferma che l’hardware è soltanto una parte dell’equazione. Uno studio comparativo pubblicato su arXiv nel 2025 ha rilevato differenze significative tra MLX, MLC-LLM, llama.cpp, Ollama e PyTorch MPS: MLX ha ottenuto il throughput di generazione sostenuto più elevato nelle condizioni analizzate, mentre altre soluzioni hanno mostrato vantaggi nella latenza iniziale o nella semplicità di distribuzione. Gli autori osservano anche che le piattaforme Nvidia mantengono un vantaggio nelle prestazioni assolute, pur riconoscendo la crescente maturità dell’inferenza privata su Mac.
Gli acceleratori neurali cambiano il ruolo della GPU
Con la famiglia M5, Apple ha inserito un Neural Accelerator in ciascun core della GPU. L’obiettivo è velocizzare le moltiplicazioni di matrici, operazioni centrali nell’elaborazione dei prompt e in numerosi carichi di machine learning.
Un lavoro indipendente dedicato al runtime BaseRT ha misurato, su M5 Pro e con modelli fino a 35 miliardi di parametri, un’elaborazione dei prompt fino a 6,4 volte più rapida rispetto a llama.cpp e fino a 3,9 volte rispetto a MLX. I risultati non possono essere trasferiti automaticamente al Mac Studio M5 Ultra, ma mostrano quanto l’accesso efficace agli acceleratori dipenda dal software. Un computer potentissimo può restare sottoutilizzato finché framework e applicazioni non vengono aggiornati per la nuova architettura.
Apple sta costruendo l’ecosistema attorno a MLX e al nuovo framework Core AI, mentre applicazioni come LM Studio e Draw Things rendono più accessibile l’esecuzione locale di modelli linguistici, generatori di immagini e strumenti agentici. La sfida sarà trasformare questi esperimenti in flussi di lavoro affidabili, riproducibili e semplici da amministrare.
Una macchina estrema, non un computer per tutti
In Italia il Mac Studio con M5 Ultra parte da 6.699 euro, mentre Apple ha annunciato la disponibilità della versione con 512GB di memoria unificata dalla fine di ottobre 2026. Il prezzo aumenta rapidamente scegliendo più memoria e spazio di archiviazione, restringendo il pubblico a laboratori, studi creativi, sviluppatori AI e aziende che possono valorizzare l’investimento.
Anche il quadro tracciato dalle recensioni internazionali è coerente: il riepilogo di dieci prove realizzato da TechRadar individua nell’AI locale e nei cluster gli scenari più convincenti per M5 Ultra, mentre considera M5 Max sufficiente per gran parte dei tradizionali lavori creativi. Sul rendering e sul gaming, inoltre, le GPU discrete Nvidia di fascia alta conservano vantaggi importanti.
- Ha senso per chi deve elaborare localmente documenti, codice o dati sensibili.
- Può ridurre la dipendenza dal cloud in presenza di carichi AI intensivi e continuativi.
- Non sostituisce automaticamente i migliori modelli proprietari disponibili come servizio.
- Richiede software ottimizzato per sfruttare pienamente GPU e Neural Accelerator.
- Per creatività generalista e uso quotidiano, M5 Max resta la scelta più razionale.
Il vero anticipo del futuro è l’AI personale
Il Mac Studio M5 Ultra non sancisce la fine del cloud. I modelli più capaci continueranno a richiedere grandi cluster, aggiornamenti frequenti e infrastrutture specializzate. La novità è un’altra: una parte crescente dell’intelligenza artificiale può essere spostata dal data center al dispositivo dell’utente.
Per professionisti e organizzazioni, questo significa poter combinare due livelli: modelli locali per attività private, ripetitive o sensibili e servizi cloud per i problemi più complessi. Apple sta scommettendo proprio su questo scenario ibrido. Oggi è una possibilità costosa e di nicchia; con modelli più efficienti e acceleratori meglio supportati, potrebbe diventare una componente ordinaria del personal computing.
In questa prospettiva, il risultato più importante del Mac Studio non è soltanto la capacità di caricare un LLM da 122 miliardi di parametri. È mostrare come potrebbe cambiare il rapporto con l’AI: non più esclusivamente un servizio remoto da interrogare, ma una risorsa computazionale privata, sempre disponibile e fisicamente presente sulla scrivania.